El 15 de septiembre apareció en el AI Gateway de Vercel un modelo que no puede escribir una oración. No puede llamar a una tool, no puede explicarse, y su output máximo es de cero tokens. Tres días después Vercel escribió que había llegado a casi el 13% de los equipos pagos en sus primeras 24 horas, el doble que cualquier lanzamiento anterior y seis veces lo que logró Fable 5.1 en su primer día. El modelo es Jev, de una empresa llamada TypeSafe, y es el primero de lo que ellos llaman modelos System One. Pasé esta semana armando un loop de QA en el browser encima de él. Esto es qué es, por qué creo que el entusiasmo está justificado, qué construí y cómo se ven los números al lado de los LLMs por los que ya estás pagando.
Una nota práctica antes del argumento: al momento de escribir esto, Vercel tiene una promoción de lanzamiento y Jev es gratis en AI Gateway hasta el 25 de septiembre. Después cuesta USD 0.042 por millón de tokens de input, y el output es gratis porque no hay output. De cualquier manera cuesta casi nada, y eso es parte de la historia.
Qué es Jev, en un párrafo
Le pasás a Jev un estado (un string, un objeto JSON, hasta 32k tokens) y un conjunto de preguntas. Cada pregunta es una de tres primitivas: un boolean ("¿se cumple esta afirmación?"), un choice ("¿cuál de estas opciones?") o un score ("¿dónde cae en esta escala ordenada?"). Responde cada pregunta con un valor tipado y una distribución de probabilidad, y nada más. Sin prosa, sin traza de razonamiento, sin JSON para parsear. TypeSafe lo entrena con un método que llaman Reinforcement Learning for Calibrated Decisions, así que las probabilidades se optimizan contra resultados y no contra la preferencia de un humano por una respuesta linda. Un 0.97 debería acertar más o menos el 97% de las veces.
Con el AI SDK se ve así:
import { experimental_evaluate as evaluate } from 'ai';

const result = await evaluate({
  model: 'typesafe-ai/jev',
  state: { url, title, visibleText },
  questions: {
    signedIn: {
      type: 'boolean',
      instructions: 'Is the user signed in, judging from the page?',
    },
    section: {
      type: 'choice',
      instructions: 'Which section is the page showing?',
      criteria: { dashboard: null, login: null, other: null },
    },
  },
});
// result.answers.signedIn.probability   -> 0.9
// result.answers.section.choice         -> 'dashboard'
// result.answers.section.probabilities  -> { dashboard: 1, login: 0, other: 0 }
Esa es toda la API. El paquete ai sumó experimental_evaluate en la 7.0.105 exactamente para esta clase de modelo, y el gateway lo expone como un "evaluation model" al lado de los modelos de lenguaje, de embeddings y de imágenes. Es una columna nueva en el catálogo, no una fila nueva.
Por qué esto es más importante que un clasificador barato
Fijate dónde están realmente las llamadas a LLMs en un codebase en producción. Una minoría genera texto que va a leer un humano. La mayoría toma una decisión sobre la que va a actuar el código: rutear este ticket, ¿este CV cumple la pregunta excluyente?, ¿este mensaje es urgente?, ¿cuál de estos cinco candidatos es el que el usuario quiso decir?, ¿este paso salió bien? Durante tres años la forma de obtener esa decisión fue pedirle a un modelo de chat que por favor responda en JSON, parsear el JSON, reintentar cuando no parsea, y tratar la respuesta como binaria porque el modelo no te da un número honesto de qué tan seguro está.
Cada una de esas llamadas paga por generación. Pagás los tokens de output, esperás a que se hagan stream, y heredás un modo de falla (output mal formado) que no tiene nada que ver con la decisión. Los modos de structured output hicieron el parseo más confiable pero no lo hicieron más rápido ni más barato, y los logprobs, donde existen, no están calibrados. Jev elimina el paso de generación por completo. La decisión es el output. No hay nada que parsear, nada que reintentar por problemas de formato, y el número que vuelve significa lo que dice.
La consecuencia es que las decisiones se vuelven lo suficientemente baratas como para tomar muchas. Hacé cinco preguntas sobre el mismo estado y corren en paralelo en un solo request. Hacé una pregunta especulativa que capaz no necesitás. Puntuá a cada candidato en cuatro dimensiones y dejá que el ranking sea una suma ponderada que podés cambiar sin otra inferencia. Es una forma distinta de escribir software alrededor de un modelo, y es por eso que la documentación de TypeSafe se lee más como una guía de programación que como una guía de prompting. El modelo es una primitiva. El código es dueño del workflow.
Lo que Jev no puede hacer es igual de importante, porque los límites son el diseño. No genera, así que no puede escribir un selector, un resumen, un mail ni una línea de código. No puede planificar. Lee texto, no imágenes. Si tu tarea necesita algo de eso, seguís necesitando un modelo de lenguaje. El modelo mental correcto no es "un LLM más chico" sino "el juicio rápido y calibrado que ponés antes, al lado o después del LLM".
Qué construí: un loop de QA donde Playwright maneja y Jev juzga
El testing end-to-end en el browser es un buen lugar para probar esto, porque es exactamente el tipo de carga donde las herramientas actuales gastan un turno de un modelo frontier en cada click. Las herramientas de QA basadas en agentes (Expect, browser-use y compañía) le dan un browser a un agente de código y lo dejan planificar, clickear, tipear y verificar. Funciona, es lento, y es caro de la forma que se acumula: un flow de 20 pasos son 20 o más turnos del agente.
La división con la que terminé es simple y defendería cada línea:
| Playwright (código) | Jev (modelo) | |
|---|---|---|
| Navegación, tipeo, esperas | sí | |
| Video, trace, screenshots | sí | |
| "¿Se cumple esta afirmación en la página?" | sí, una pregunta boolean | |
| "¿Qué control visible coincide con esta intención?" | sí, un choice entre los controles que encontró el código | |
| "¿Cuál es el próximo click hacia este objetivo?" | sí, un choice entre las acciones observadas o DONE / BLOCKED / WAIT |
El ingreso de texto nunca pasa cerca del modelo. El código saca un snapshot de la página (URL, título, texto visible deduplicado, el árbol aria, y cada control clickeable visible etiquetado con un índice), y Jev solo elige entre cosas que el código ya encontró. Nunca inventa un selector. Es la misma forma que el bridge jev-browser-use que alguien publicó para Codex esta semana, adaptado a Playwright pelado para que corra en cualquier lado.
Encima de las tres primitivas armé lo que un equipo realmente necesita:
- Una CLI para agentes. Un flow es un array JSON de pasos. La CLI lo corre headless, lo filma e imprime un único resultado JSON con pass o fail por paso, la probabilidad detrás de cada juicio, el path al video y el path a un screenshot final. Exit code 0 o 1. Las credenciales se referencian como placeholders
${QA_EMAIL}y se sustituyen desde el entorno de la propia CLI, así que un agente que escribe un flow nunca las ve. - Un dashboard. Un único archivo HTML servido localmente, en inglés, español o portugués. Cada run, cada test, cada decisión de Jev con su probabilidad, latencia y cantidad de tokens, con el video embebido.
- Un skill. Un
SKILL.mdque le enseña a Claude Code, Codex, Cursor o Grok Build cómo escribir un flow y cómo leer el resultado. "Testeá este branch en el browser" pasa a ser algo que un agente puede hacer sin un humano mirando.
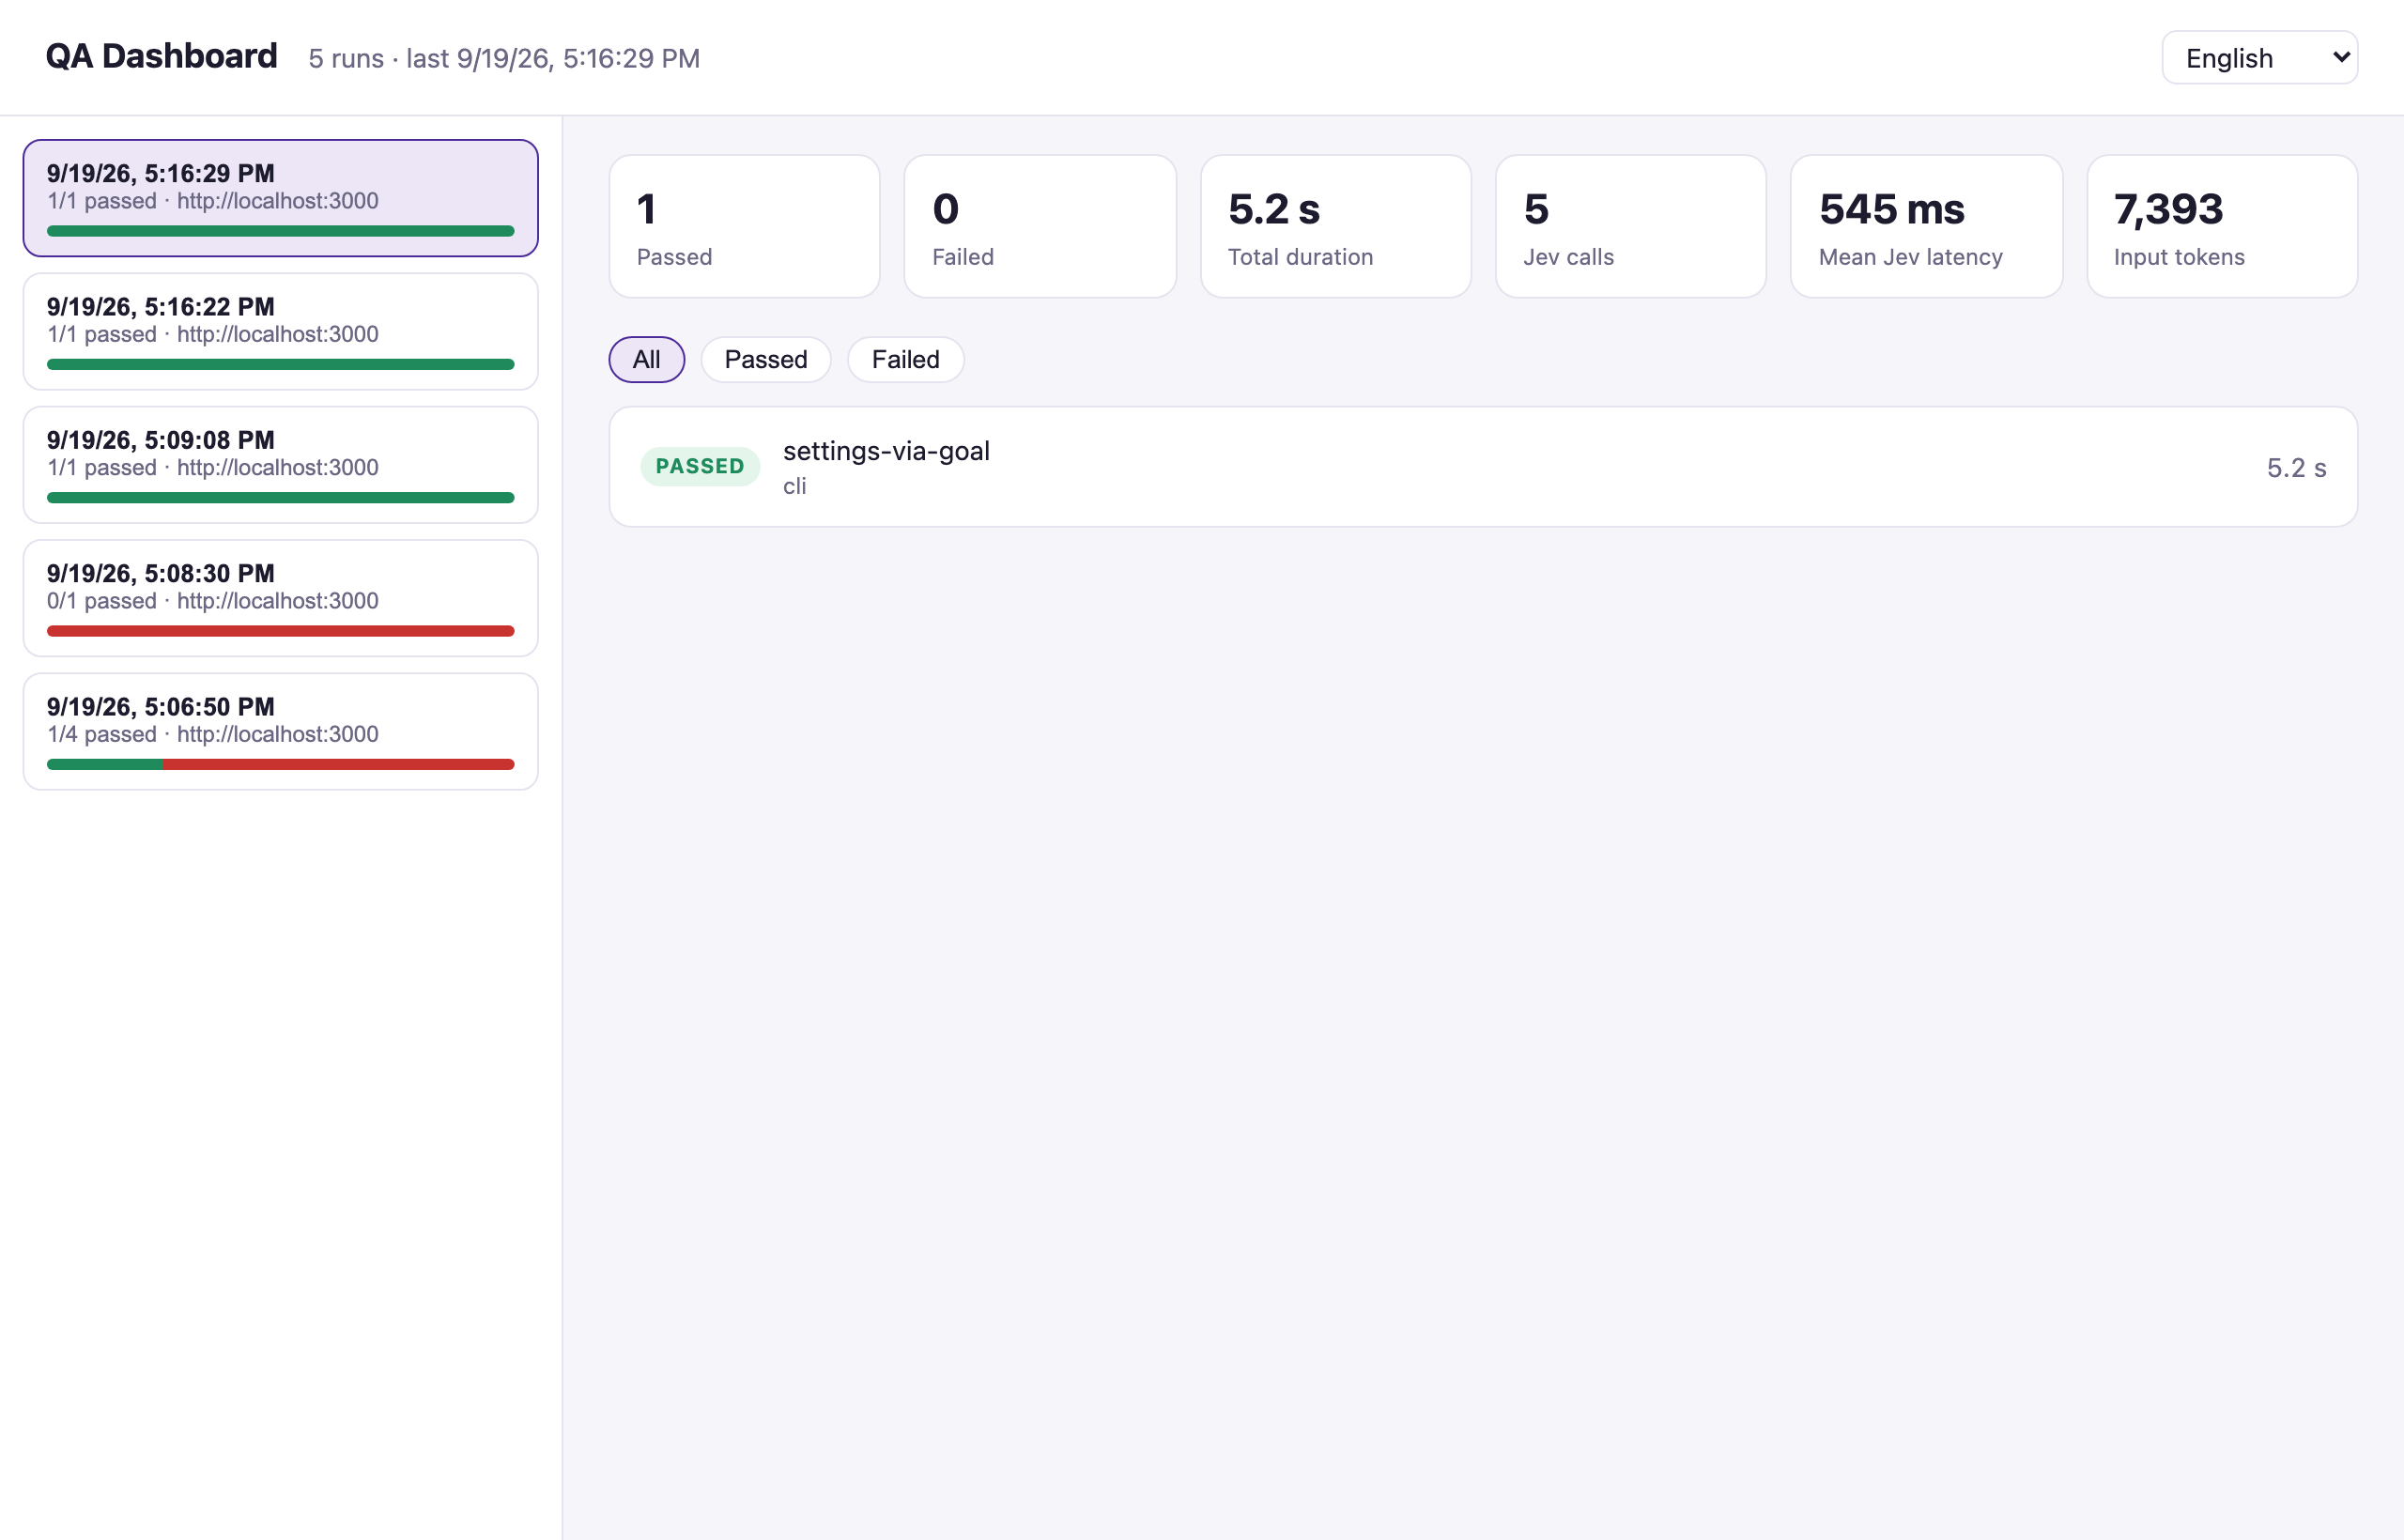
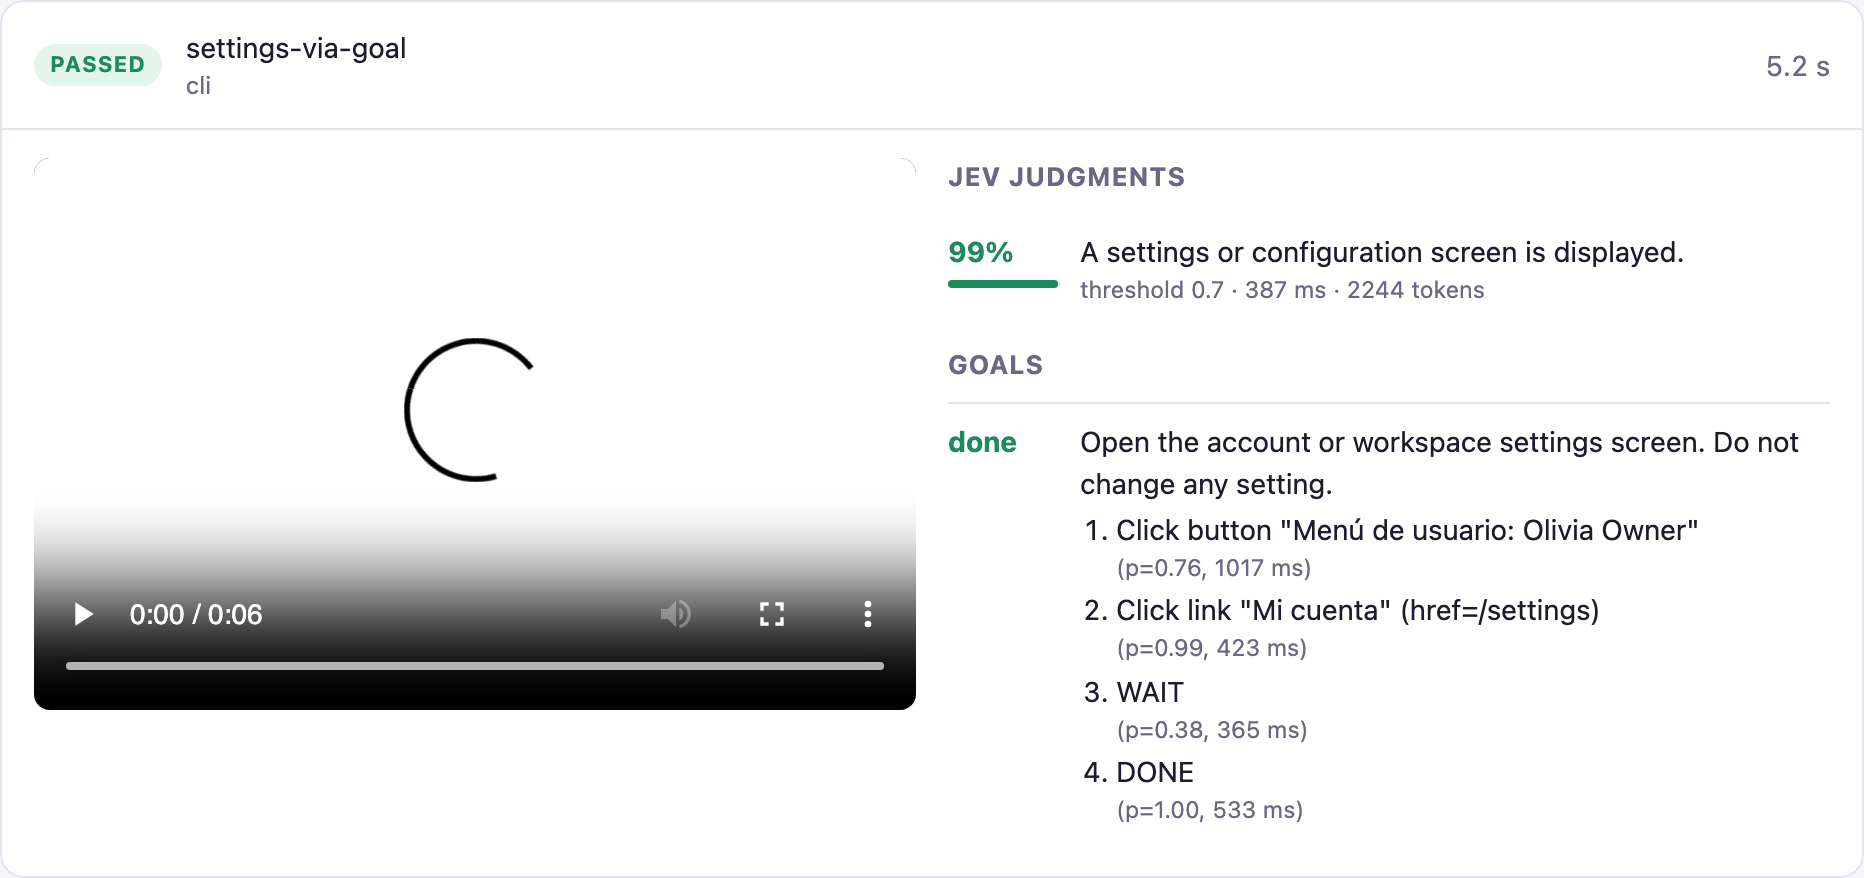
Acá va un run real contra nuestro producto. El flow hace login de forma determinística, después le pasa un objetivo a Jev y después le pide que verifique:
{ "goal": "Open the account or workspace settings screen. Do not change any setting.",
  "maxSteps": 8,
  "denyNames": ["cerrar sesi", "logout", "eliminar", "delete", "guardar", "save"] },
{ "expect": "A settings or configuration screen is displayed." }
[8/9] goal: Open the account or workspace settings screen. Do not change any setting.
step 1: Click button "Menú de usuario: Olivia Owner" p=0.76
step 2: Click link "Mi cuenta" (href=/settings) p=0.99
step 3: WAIT p=0.38
step 4: DONE p=1.00
passed (3245 ms)
[9/9] expect: A settings or configuration screen is displayed.
passed p=0.99 (443 ms)Cuatro decisiones, 3.2 segundos incluyendo la carga de las páginas, y la tercera es mi favorita: la página estaba en plena transición después del click, y en lugar de clickear otra cosa Jev eligió WAIT con una probabilidad baja, que es exactamente lo que tiene que decir un modelo cuando el estado es ambiguo. En el flow de login, cuando le pedí "the button that submits the login form", eligió "Iniciar sesión" con 0.97 en una página en español que nunca había visto. La intención estaba en inglés. No importó.
Los números
A Jev lo medí yo. Veinte llamadas secuenciales a través de AI Gateway desde Buenos Aires, cada una con una pregunta boolean y una choice sobre un estado de página realista de unos 400 tokens:
| Jev vía AI Gateway | Valor |
|---|---|
| Latencia p50 (ida y vuelta) | 388 ms |
| Latencia p90 | 471 ms |
| mín / máx | 330 ms / 883 ms |
| Tokens de input por llamada | 395 (juicios), ~1,500 (pasos de objetivo con la lista de controles) |
| Costo por juicio | USD 0.0000166. Mil assertions por menos de dos centavos. |
La comparación de abajo es la parte para leer con cuidado. Los otros modelos no los corrí: tomé los precios de lista de la página de pricing de cada proveedor y las latencias de Artificial Analysis, y calculé cuánto costaría el mismo juicio si se lo pidieras a un modelo de lenguaje como un objeto JSON chico: 750 tokens de input (el estado más la pregunta) y 25 de output. El time to first token es la cifra publicada para la configuración sin reasoning cuando existe; el tiempo total suma esos 25 tokens a la velocidad de output publicada. Tomá la columna de latencia como una estimación y la de costo como aritmética.
| Modelo | Precio in / out (USD por 1M) | Costo por juicio | vs Jev | Latencia estimada |
|---|---|---|---|---|
| Jev (medido) | 0.042 / 0 | 0.0000315 | 1x | 0.39 s medido |
| GPT-5 nano | 0.05 / 0.40 | 0.0000475 | 1.5x | ~0.5 a 1 s sin reasoning (76 s con reasoning en high, según Artificial Analysis) |
| GPT-5 mini | 0.25 / 2.00 | 0.00024 | 7.6x | ~1 s sin reasoning |
| Gemini 3.5 Flash-Lite | 0.30 / 2.50 | 0.00029 | 9.2x | ~0.5 s sin thinking (9.4 s con thinking) |
| Claude Haiku 4.5 | 1.00 / 5.00 | 0.000875 | 28x | ~1.0 s (0.69 s TTFT + 25 tokens a 83 tok/s) |
| Gemini 3.5 Flash | 1.50 / 9.00 | 0.00135 | 43x | ~1 s sin thinking (15 s con) |
| Claude Sonnet 5 | 2.00 / 10.00 | 0.00175 | 56x | ~1.5 a 2 s |
| Claude Fable 5.1 | 10.00 / 50.00 | 0.00875 | 278x | varios segundos |
Se destacan tres cosas. Primero, los LLMs más baratos están a un múltiplo chico de Jev en precio, así que en el tier nano el costo solo no es el argumento; la latencia y la calibración sí. Segundo, los modelos que la gente realmente usa cuando quiere un juicio en el que pueda confiar (Haiku, Flash, Sonnet) cuestan entre 30 y 60 veces más y tienen entre dos y cinco veces la latencia, y aun así no te dan una probabilidad. Tercero, la cifra de titular de TypeSafe, "194x faster and 445x cheaper", es contra workflows de tipo reasoning, y una vez que mirás las latencias con reasoning en esa tabla (76 segundos para nano en high) deja de sonar a marketing. Para el loop de QA la comparación que importa es por flow: el run de settings de arriba tomó cinco decisiones por USD 0.0003. Corrélo después de cada commit en cada branch y la factura sigue siendo cero.
Lo que aprendí en una semana
- Escribí las afirmaciones como un QA engineer escribe resultados esperados. "Se muestra una lista de posiciones abiertas, o un estado vacío que invita a crear la primera" funciona. "La página está bien" no. Cuando una afirmación es sutil, dale criterios explícitos de verdadero y falso; el modelo los usa.
- Una probabilidad cerca de tu umbral es feedback sobre la afirmación, no sobre el umbral. Afilá la pregunta. No bajes la vara.
- Las deny lists no son opcionales en un loop de acciones. Jev va a elegir "Cerrar sesión" sin problema si es el único control que parece avanzar. El loop solo ofrece controles únicos y permitidos, y los nombres destructivos nunca se ofrecen.
- Texto, no píxeles. Jev nunca ve el screenshot. Las regresiones visuales siguen necesitando un modelo de visión o un diff de píxeles. El screenshot del reporte es para el humano.
- La calibración es por población, no por respuesta. La documentación lo dice y se nota: un 0.76 en "clickear el menú de usuario" fue el click correcto, y un 0.38 en WAIT fue la duda correcta. Leé la distribución, no solo el argmax.
- Se combina con las herramientas de agentes que ya usás. El lugar natural para esto no es reemplazar a Expect o a un agente de código, sino ser la capa mecánica a la que llaman para dejar de gastar un turno por click. Eso es justamente lo que hace el bridge de Codex, y lo que hacen la CLI y el skill de acá para todo lo demás.
Probalo
El proyecto es open source en github.com/jonymusky/jev-browser-qa. Es chico a propósito: tres primitivas, una CLI, un dashboard, un skill y un README que dice lo que Jev no va a hacer.
git clone https://github.com/jonymusky/jev-browser-qa && cd jev-browser-qa
pnpm install && pnpm exec playwright install chromium
cp .env.example .env          # AI_GATEWAY_API_KEY, BASE_URL, QA_EMAIL, QA_PASSWORD
pnpm jev:smoke                # one call, no browser
pnpm -s qa run flows/login.json
pnpm dashboard                # http://localhost:4310
Y para tu agente: npx skills add https://github.com/jonymusky/jev-browser-qa --skill jev-qa. Lo vengo corriendo desde Claude Code y desde Grok Build, el agente de terminal de xAI, que lee Agent Skills y AGENTS.md sin ninguna configuración: el mismo prompt, "test this branch with jev-qa and report the verdict with the video path", funciona en los dos, y ninguno de los agentes ve nunca una credencial porque los flows llevan placeholders ${QA_EMAIL} que resuelve la CLI. En el repo hay un walkthrough corto de Grok Build, que incluye la forma headless grok -p para CI. Si querés probarlo sin instalar nada, publiqué un bot de Grok con el skill precargado: QA Engineer. Pasale la URL de tu app y el flow que querés verificar, y te devuelve el veredicto, el video y el screenshot.
En este post tuve cuidado de separar lo que medí de lo que inferí, porque las promesas alrededor de Jev son grandes y el modelo tiene cuatro días. Pero el diseño no es un truco. Un modelo que devuelve una decisión calibrada en lugar de un párrafo, en 400 milisegundos, por una fracción de centavo, cambia en qué partes de tu sistema es razonable poner un modelo. Hasta ahora la respuesta era "en las partes que se lo pueden permitir". Desde esta semana la respuesta se parece más a "en cualquier lugar donde, si no, escribirías un if y te sentirías mal por eso".