Em 15 de setembro apareceu no AI Gateway da Vercel um modelo que não consegue escrever uma frase. Ele não chama tools, não se explica, e seu output máximo é zero tokens. Três dias depois a Vercel escreveu que ele tinha chegado a quase 13% dos times pagantes nas primeiras 24 horas, o dobro de qualquer lançamento anterior e seis vezes o que o Fable 5.1 conseguiu no primeiro dia. O modelo é o Jev, de uma empresa chamada TypeSafe, e é o primeiro do que eles chamam de modelos System One. Passei esta semana construindo um loop de QA no browser em cima dele. Aqui está o que ele é, por que acho que a empolgação é merecida, o que eu construí e como ficam os números ao lado dos LLMs que você já paga.
Uma nota prática antes do argumento: no momento em que escrevo, a Vercel está com uma promoção de lançamento e o Jev é gratuito no AI Gateway até 25 de setembro. Depois disso custa USD 0.042 por milhão de tokens de input, e o output é gratuito porque não existe output. De qualquer forma custa quase nada, e isso faz parte da história.
O que é o Jev, em um parágrafo
Você passa ao Jev um estado (uma string, um objeto JSON, até 32k tokens) e um conjunto de perguntas. Cada pergunta é uma de três primitivas: um boolean ("esta afirmação é verdadeira?"), um choice ("qual destas opções?") ou um score ("onde fica nesta escala ordenada?"). Ele responde cada pergunta com um valor tipado e uma distribuição de probabilidade, e nada mais. Sem prosa, sem trace de raciocínio, sem JSON para parsear. A TypeSafe treina o modelo com um método que eles chamam de Reinforcement Learning for Calibrated Decisions, então as probabilidades são otimizadas contra resultados, e não contra a preferência de um humano por uma resposta bonita. Um 0.97 deveria acertar cerca de 97% das vezes.
Pelo AI SDK fica assim:
import { experimental_evaluate as evaluate } from 'ai';

const result = await evaluate({
  model: 'typesafe-ai/jev',
  state: { url, title, visibleText },
  questions: {
    signedIn: {
      type: 'boolean',
      instructions: 'Is the user signed in, judging from the page?',
    },
    section: {
      type: 'choice',
      instructions: 'Which section is the page showing?',
      criteria: { dashboard: null, login: null, other: null },
    },
  },
});
// result.answers.signedIn.probability   -> 0.9
// result.answers.section.choice         -> 'dashboard'
// result.answers.section.probabilities  -> { dashboard: 1, login: 0, other: 0 }
Essa é a API inteira. O pacote ai adicionou experimental_evaluate na 7.0.105 exatamente para essa classe de modelo, e o gateway o expõe como um "evaluation model" ao lado dos modelos de linguagem, de embeddings e de imagem. É uma coluna nova no catálogo, não uma linha nova.
Por que isso é mais importante que um classificador barato
Olhe onde as chamadas a LLMs realmente estão em um codebase em produção. Uma minoria gera texto que um humano vai ler. A maioria toma uma decisão sobre a qual o código vai agir: rotear este ticket, este CV atende à pergunta eliminatória?, esta mensagem é urgente?, qual destes cinco candidatos é o que o usuário quis dizer?, este passo deu certo? Por três anos, o jeito de obter essa decisão foi pedir a um modelo de chat que, por favor, respondesse em JSON, parsear o JSON, tentar de novo quando não parseia, e tratar a resposta como binária porque o modelo não te dá um número honesto de quão seguro ele está.
Cada uma dessas chamadas paga por geração. Você paga pelos tokens de output, espera o stream deles, e herda um modo de falha (output malformado) que não tem nada a ver com a decisão. Os modos de structured output deixaram o parsing mais confiável, mas não mais rápido nem mais barato, e os logprobs, onde existem, não são calibrados. O Jev elimina a etapa de geração por completo. A decisão é o output. Não há nada para parsear, nada para tentar de novo por questões de formatação, e o número que volta significa o que diz.
A consequência é que decisões ficam baratas o suficiente para você tomar muitas. Faça cinco perguntas sobre o mesmo estado e elas rodam em paralelo em um único request. Faça uma pergunta especulativa que talvez você nem precise. Dê nota a cada candidato em quatro dimensões e deixe o ranking ser uma soma ponderada que você pode mudar sem outra inferência. É um jeito diferente de escrever software em volta de um modelo, e é por isso que a documentação da TypeSafe parece mais um guia de programação do que um guia de prompting. O modelo é uma primitiva. O código é dono do workflow.
O que o Jev não consegue fazer é igualmente importante, porque os limites são o design. Ele não gera, então não consegue escrever um seletor, um resumo, um e-mail ou uma linha de código. Não consegue planejar. Lê texto, não imagens. Se a sua tarefa precisa de alguma dessas coisas, você ainda precisa de um modelo de linguagem. O modelo mental certo não é "um LLM menor", e sim "o julgamento rápido e calibrado que você coloca antes, ao lado ou depois do LLM".
O que eu construí: um loop de QA em que o Playwright dirige e o Jev julga
Testes end-to-end no browser são um bom lugar para experimentar isso, porque é exatamente o tipo de carga em que as ferramentas atuais gastam um turno de um modelo de fronteira a cada clique. Ferramentas de QA baseadas em agentes (Expect, browser-use e similares) entregam um browser a um agente de código e deixam ele planejar, clicar, digitar e verificar. Funciona, é lento, e é caro do jeito que vai somando: um flow de 20 passos são 20 ou mais turnos do agente.
A divisão a que cheguei é simples, e eu defenderia cada linha dela:
| Playwright (código) | Jev (modelo) | |
|---|---|---|
| Navegação, digitação, esperas | sim | |
| Vídeo, trace, screenshots | sim | |
| "Esta afirmação é verdadeira na página?" | sim, uma pergunta boolean | |
| "Qual controle visível corresponde a esta intenção?" | sim, um choice entre os controles que o código encontrou | |
| "Qual é o próximo clique rumo a este objetivo?" | sim, um choice entre as ações observadas ou DONE / BLOCKED / WAIT |
A digitação de texto nunca passa perto do modelo. O código tira um snapshot da página (URL, título, texto visível deduplicado, a árvore aria e cada controle clicável visível marcado com um índice), e o Jev só escolhe entre coisas que o código já encontrou. Ele nunca inventa um seletor. É o mesmo formato do bridge jev-browser-use que alguém publicou para o Codex esta semana, adaptado para Playwright puro para rodar em qualquer lugar.
Em cima das três primitivas construí o que um time realmente precisa:
- Uma CLI para agentes. Um flow é um array JSON de passos. A CLI roda tudo headless, grava em vídeo e imprime um único resultado JSON com pass ou fail por passo, a probabilidade por trás de cada julgamento, o caminho do vídeo e o caminho de um screenshot final. Exit code 0 ou 1. As credenciais são referenciadas como placeholders
${QA_EMAIL}e substituídas a partir do ambiente da própria CLI, então um agente que escreve um flow nunca as vê. - Um dashboard. Um único arquivo HTML servido localmente, em inglês, espanhol ou português. Cada run, cada teste, cada decisão do Jev com sua probabilidade, latência e contagem de tokens, com o vídeo embutido.
- Uma skill. Um
SKILL.mdque ensina Claude Code, Codex, Cursor ou Grok Build a escrever um flow e a ler o resultado. "Teste este branch no browser" vira algo que um agente consegue fazer sem um humano olhando.
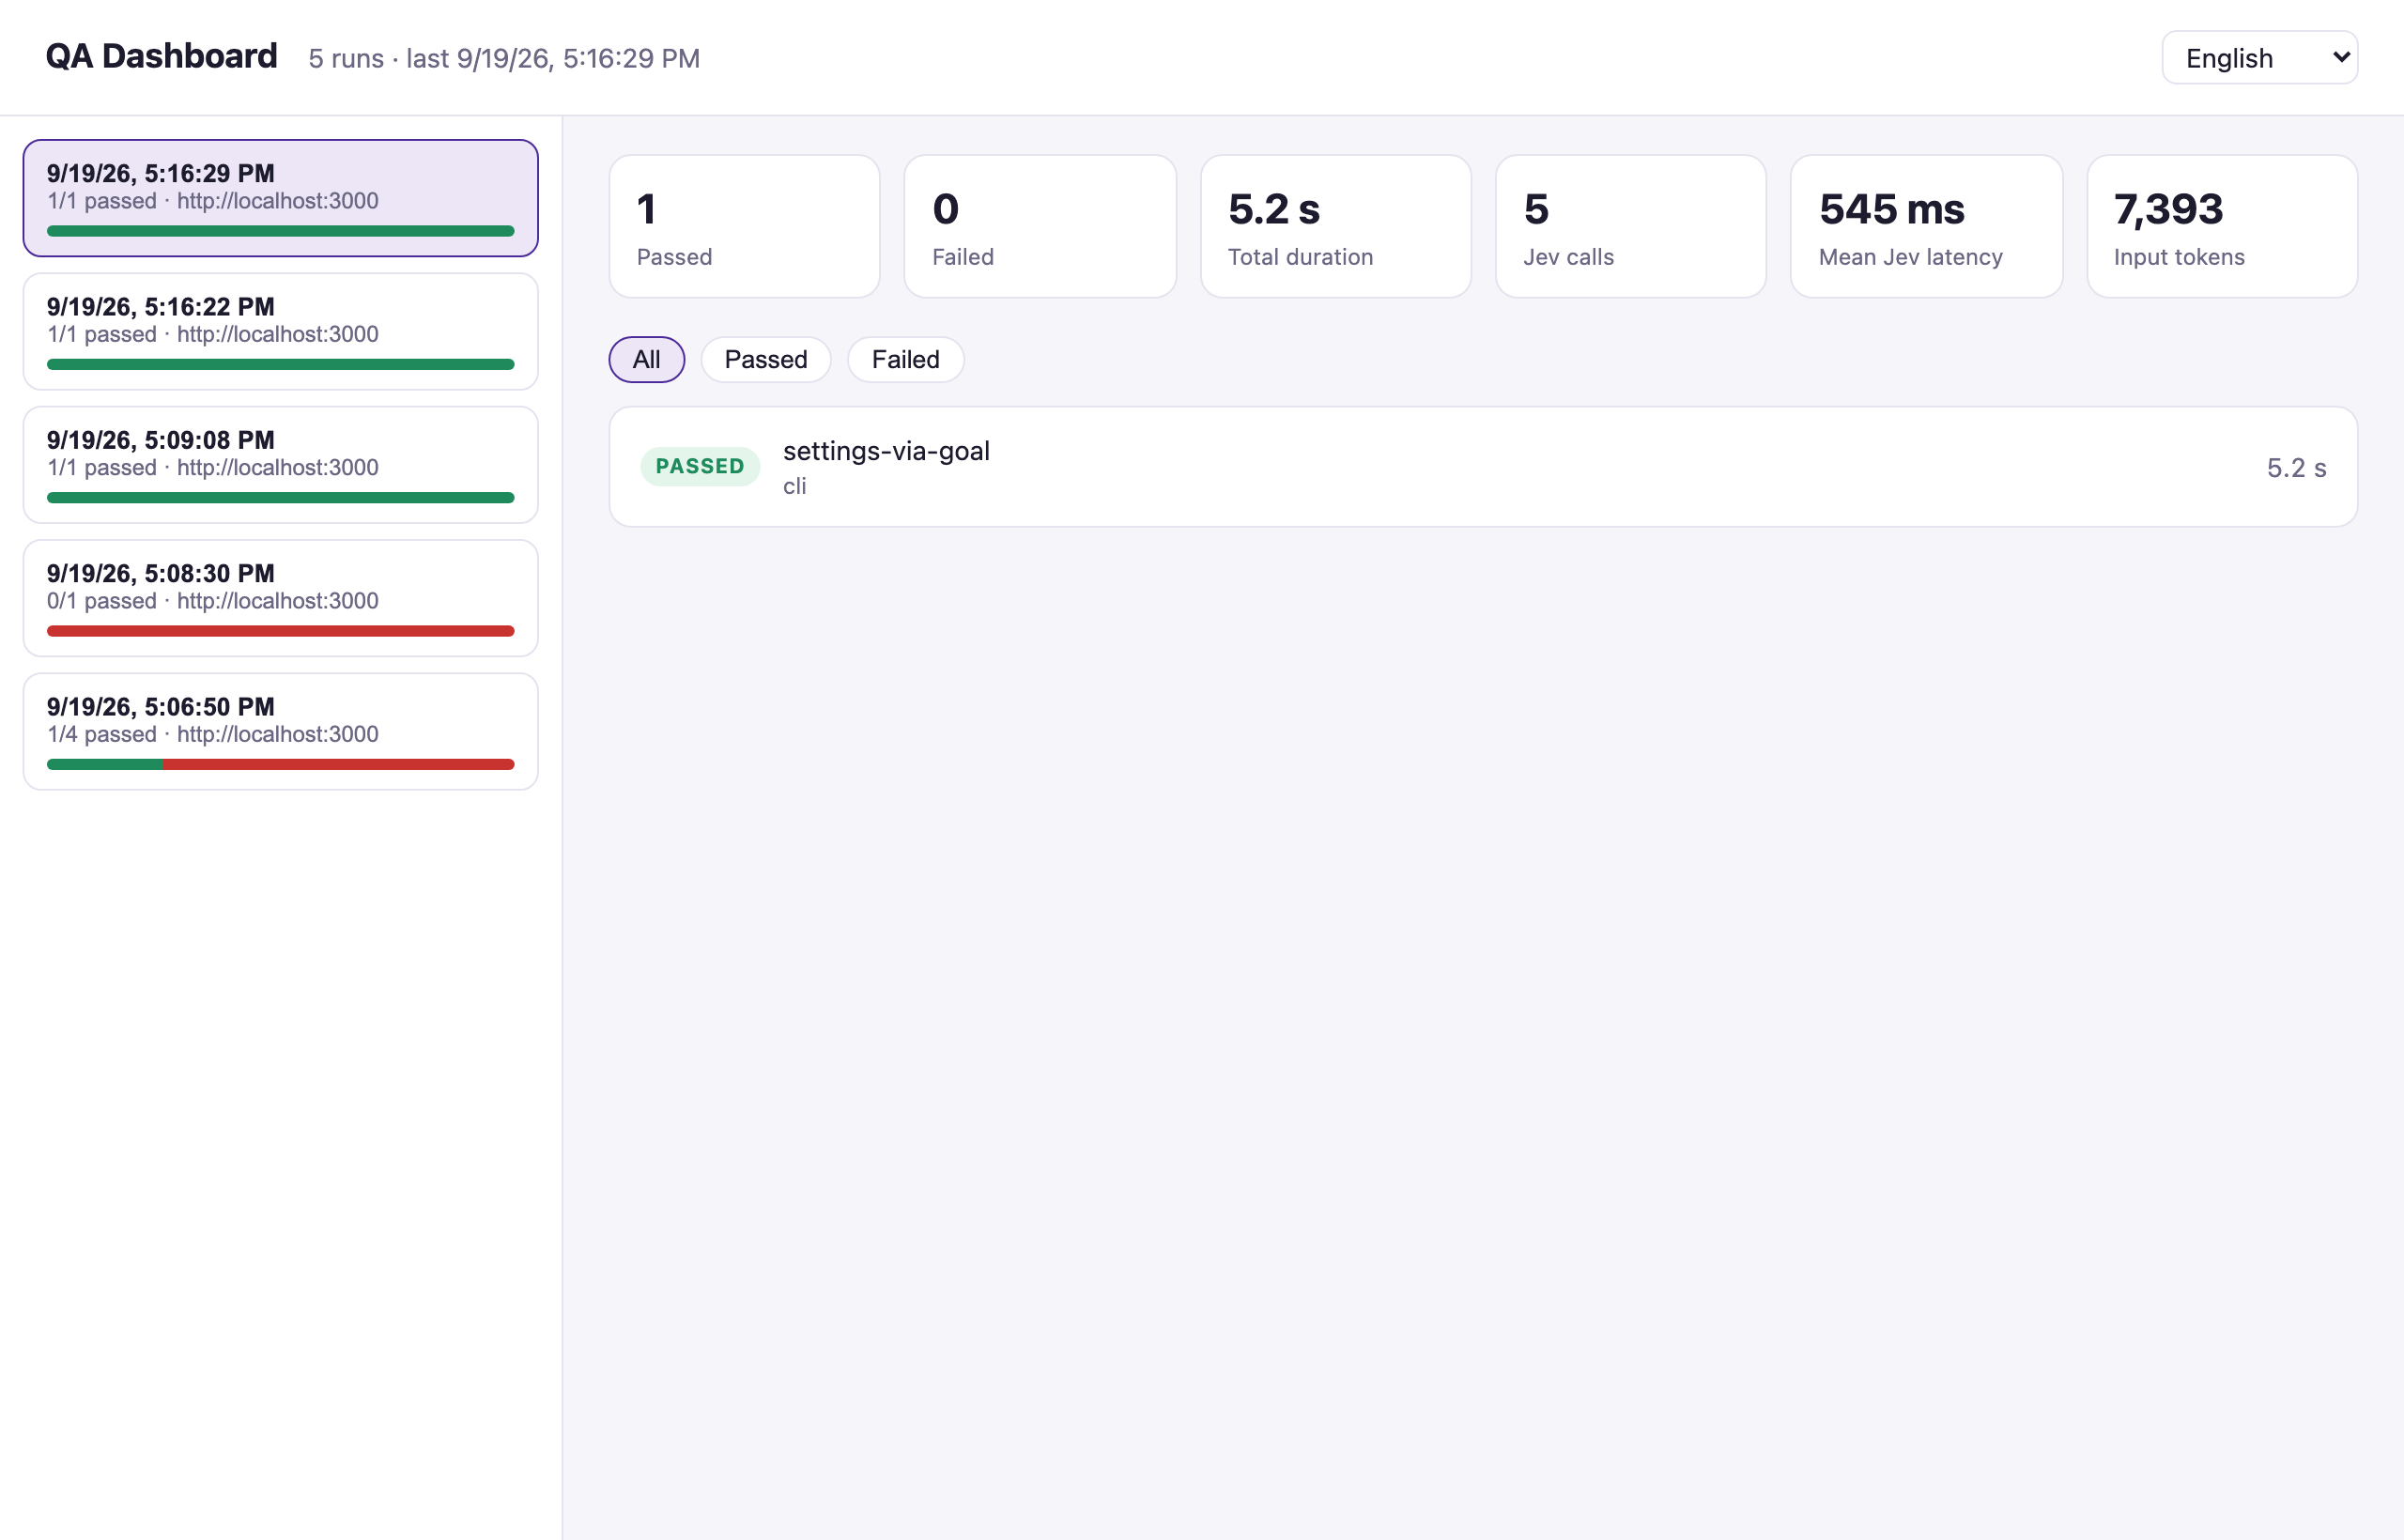
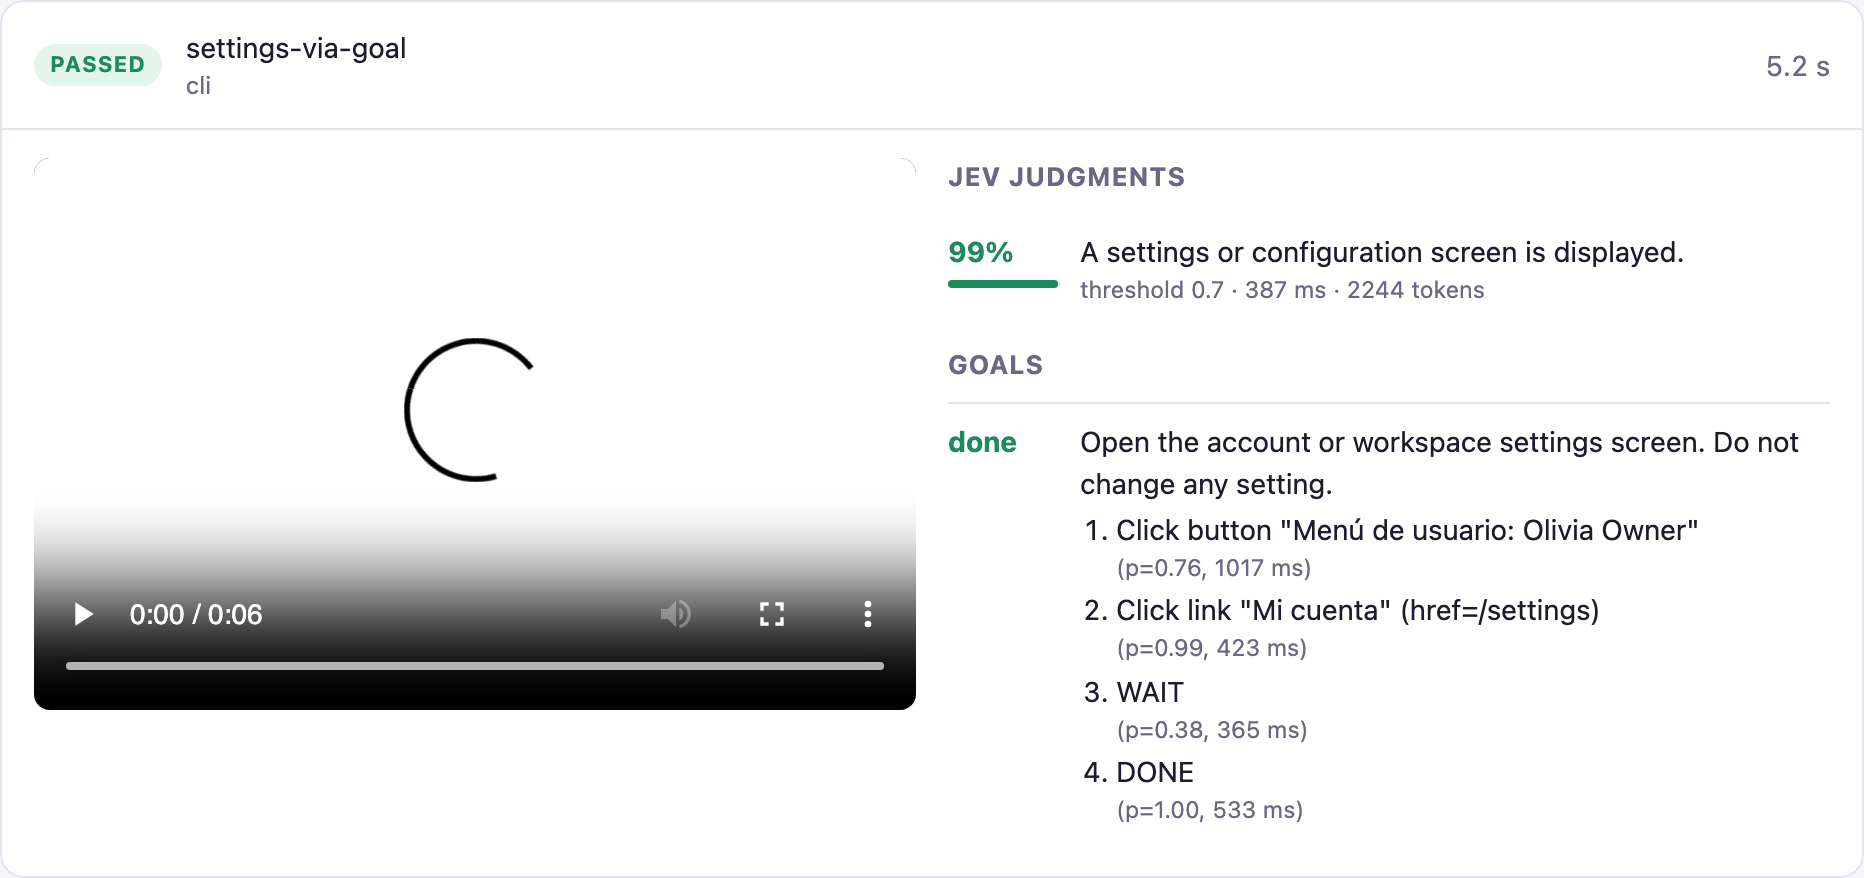
Aqui está um run real contra o nosso produto. O flow faz login de forma determinística, depois passa um objetivo ao Jev e depois pede que ele verifique:
{ "goal": "Open the account or workspace settings screen. Do not change any setting.",
  "maxSteps": 8,
  "denyNames": ["cerrar sesi", "logout", "eliminar", "delete", "guardar", "save"] },
{ "expect": "A settings or configuration screen is displayed." }
[8/9] goal: Open the account or workspace settings screen. Do not change any setting.
step 1: Click button "Menú de usuario: Olivia Owner" p=0.76
step 2: Click link "Mi cuenta" (href=/settings) p=0.99
step 3: WAIT p=0.38
step 4: DONE p=1.00
passed (3245 ms)
[9/9] expect: A settings or configuration screen is displayed.
passed p=0.99 (443 ms)Quatro decisões, 3.2 segundos incluindo o carregamento das páginas, e a terceira é a minha favorita: a página estava no meio de uma transição depois do clique, e em vez de clicar em outra coisa o Jev escolheu WAIT com uma probabilidade baixa, que é exatamente o que um modelo deveria dizer quando o estado é ambíguo. No flow de login, quando pedi "the button that submits the login form", ele escolheu "Iniciar sesión" com 0.97 em uma página em espanhol que nunca tinha visto. A intenção estava em inglês. Não fez diferença.
Os números
O Jev eu medi pessoalmente. Vinte chamadas sequenciais pelo AI Gateway a partir de Buenos Aires, cada uma com uma pergunta boolean e uma choice sobre um estado de página realista de uns 400 tokens:
| Jev via AI Gateway | Valor |
|---|---|
| Latência p50 (ida e volta) | 388 ms |
| Latência p90 | 471 ms |
| mín / máx | 330 ms / 883 ms |
| Tokens de input por chamada | 395 (julgamentos), ~1,500 (passos de objetivo com a lista de controles) |
| Custo por julgamento | USD 0.0000166. Mil assertions por menos de dois centavos. |
A comparação abaixo é a parte para ler com atenção. Eu não rodei os outros modelos: peguei os preços de tabela na página de pricing de cada provedor e as latências do Artificial Analysis, e calculei quanto custaria o mesmo julgamento se você pedisse a um modelo de linguagem como um pequeno objeto JSON: 750 tokens de input (o estado mais a pergunta) e 25 de output. O time to first token é o número publicado para a configuração sem reasoning, quando ela existe; o tempo total soma esses 25 tokens na velocidade de output publicada. Trate a coluna de latência como estimativa e a de custo como aritmética.
| Modelo | Preço in / out (USD por 1M) | Custo por julgamento | vs Jev | Latência estimada |
|---|---|---|---|---|
| Jev (medido) | 0.042 / 0 | 0.0000315 | 1x | 0.39 s medido |
| GPT-5 nano | 0.05 / 0.40 | 0.0000475 | 1.5x | ~0.5 a 1 s sem reasoning (76 s com reasoning em high, segundo o Artificial Analysis) |
| GPT-5 mini | 0.25 / 2.00 | 0.00024 | 7.6x | ~1 s sem reasoning |
| Gemini 3.5 Flash-Lite | 0.30 / 2.50 | 0.00029 | 9.2x | ~0.5 s sem thinking (9.4 s com thinking) |
| Claude Haiku 4.5 | 1.00 / 5.00 | 0.000875 | 28x | ~1.0 s (0.69 s TTFT + 25 tokens a 83 tok/s) |
| Gemini 3.5 Flash | 1.50 / 9.00 | 0.00135 | 43x | ~1 s sem thinking (15 s com) |
| Claude Sonnet 5 | 2.00 / 10.00 | 0.00175 | 56x | ~1.5 a 2 s |
| Claude Fable 5.1 | 10.00 / 50.00 | 0.00875 | 278x | vários segundos |
Três coisas chamam a atenção. Primeiro, os LLMs mais baratos ficam a um múltiplo pequeno do Jev em preço, então no tier nano o custo sozinho não é o argumento; latência e calibração são. Segundo, os modelos que as pessoas realmente usam quando querem um julgamento confiável (Haiku, Flash, Sonnet) custam de 30 a 60 vezes mais e têm de duas a cinco vezes a latência, e ainda assim não te dão uma probabilidade. Terceiro, o número de manchete da própria TypeSafe, "194x faster and 445x cheaper", é contra workflows do tipo reasoning, e quando você olha as latências com reasoning naquela tabela (76 segundos para o nano em high) ele deixa de soar como marketing. Para o loop de QA, a comparação que importa é por flow: o run de settings acima tomou cinco decisões por USD 0.0003. Rode isso a cada commit em cada branch e a conta continua zerada.
O que aprendi em uma semana
- Escreva as afirmações do jeito que um QA engineer escreve resultados esperados. "Uma lista de vagas é exibida, ou um estado vazio convidando a criar a primeira" funciona. "A página está correta" não. Quando uma afirmação é sutil, dê critérios explícitos de verdadeiro e falso; o modelo usa.
- Uma probabilidade perto do seu threshold é feedback sobre a afirmação, não sobre o threshold. Refine a pergunta. Não abaixe a régua.
- Deny lists não são opcionais em um loop de ações. O Jev vai escolher "Cerrar sesión" numa boa se esse for o único controle que parece progresso. O loop só oferece controles únicos e permitidos, e nomes destrutivos nunca são oferecidos.
- Texto, não pixels. O Jev nunca vê o screenshot. Regressões visuais continuam precisando de um modelo de visão ou de um diff de pixels. O screenshot no relatório é para o humano.
- Calibração é por população, não por resposta. A documentação diz isso e dá para ver: um 0.76 em "clicar no menu do usuário" foi o clique certo, e um 0.38 em WAIT foi a hesitação certa. Leia a distribuição, não só o argmax.
- Combina com as ferramentas de agentes que você já usa. O lugar natural disso não é substituir o Expect ou um agente de código, e sim ser a camada mecânica que eles chamam para parar de gastar um turno por clique. É exatamente o que o bridge do Codex faz, e o que a CLI mais a skill daqui fazem para todo o resto.
Experimente
O projeto é open source em github.com/jonymusky/jev-browser-qa. Ele é pequeno de propósito: três primitivas, uma CLI, um dashboard, uma skill e um README que diz o que o Jev não vai fazer.
git clone https://github.com/jonymusky/jev-browser-qa && cd jev-browser-qa
pnpm install && pnpm exec playwright install chromium
cp .env.example .env          # AI_GATEWAY_API_KEY, BASE_URL, QA_EMAIL, QA_PASSWORD
pnpm jev:smoke                # one call, no browser
pnpm -s qa run flows/login.json
pnpm dashboard                # http://localhost:4310
E para o seu agente: npx skills add https://github.com/jonymusky/jev-browser-qa --skill jev-qa. Tenho rodado a partir do Claude Code e do Grok Build, o agente de terminal da xAI, que lê Agent Skills e AGENTS.md sem nenhuma configuração: o mesmo prompt, "test this branch with jev-qa and report the verdict with the video path", funciona nos dois, e nenhum dos agentes vê uma credencial, porque os flows levam placeholders ${QA_EMAIL} que a CLI resolve. Tem um walkthrough curto do Grok Build no repo, incluindo a forma headless grok -p para CI. Se quiser testar sem instalar nada, publiquei um bot do Grok com a skill pré-carregada: QA Engineer. Passe a URL do seu app e o flow que você quer verificar, e ele volta com o veredito, o vídeo e o screenshot.
Tomei cuidado neste post para separar o que medi do que inferi, porque as afirmações em torno do Jev são grandes e o modelo tem quatro dias de vida. Mas o design não é um truque. Um modelo que devolve uma decisão calibrada em vez de um parágrafo, em 400 milissegundos, por uma fração de centavo, muda em quais partes do seu sistema faz sentido colocar um modelo. Até agora a resposta era "nas partes que podem pagar por isso". A partir desta semana, a resposta está mais perto de "em qualquer lugar onde, de outro jeito, você escreveria um if e se sentiria mal com isso".